Le mercredi 28 mai, nous avons accueilli Lucien Ding, responsable genevois de l’Académie Noétic, lors d’un «entretien du SEM»
Noétic? Cette association propose des cours de jeux vidéo pour les jeunes. Bien au-delà d’un travail de «virtuosité» pour les joueurs, l’académie a pour vocation d’accompagner les adolescents dans une pratique raisonnée des jeux vidéo. A chaque cours, des thèmes tels que les achats dans les jeux vidéo, l’économie de l’attention, les conflits autour des écrans avec les parents, etc. sont abordés.
Lucien Ding, ancien joueur de haut niveau et doté d’une expérience de travailleur social, est un coach qui plaît aux jeunes et rassure les parents.
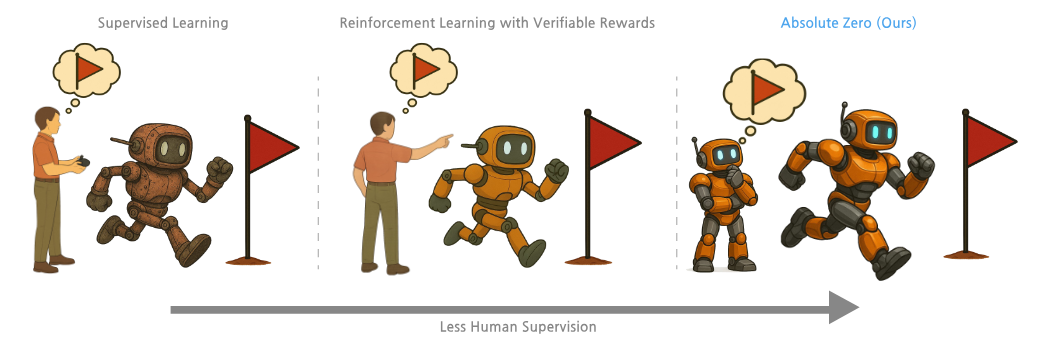
Il y a quelques semaines, je vous parlais de l’analogie d’Andrej Karpathy à propos de l’entraînement des IA qui ressemble l’apprentissage des élèves : lire son cours, faire des exercices corrigés, puis des exercices avec la solution non détaillée.
Une équipe de recherche de l’université de Tsinghua (Chine) a récemment présenté ce qu’elle a appelé le “zero human training”. Si on file la métaphore, les élèves laisseraient de côté profs et manuels scolaires pour travailler sur leurs propres exercices inventés. (Ce que font parfois… les meilleurs élèves ?)
Dans quelle langue réfléchissent les LLM* ?
Est-ce que ces modèles peuvent “planifier” au-delà du prochain mot ?
Exposent-ils fidèlement leurs raisonnements quand on les leur demande ?
(*LLM : large language model, comme chatGPT par exemple)
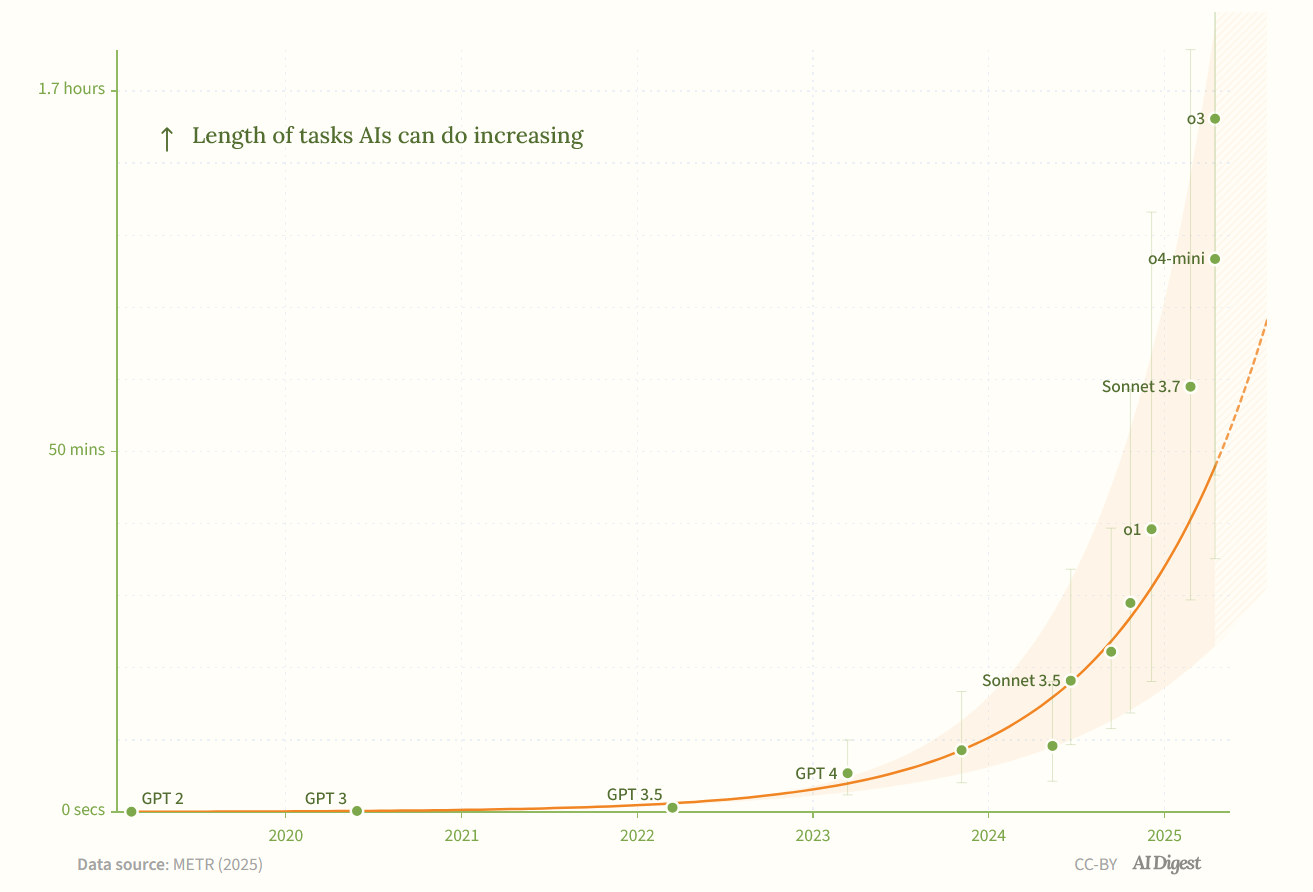
Le METR (Model Evaluation and Testing for Reliability), organisation dédiée à l’évaluation des modèles d’intelligence artificielle, vient de publier un article synthétisant des recherches vraiment intéressantes. L’objectif était de mesurer l’évolution des capacités des LLM (Large Language Model, les modèles de language qu’on retrouve par exemple dans chatGPT)
Il y a quelques semaines, Algorithmic Simplicity a publié une vidéo s’intéressant à un étrange paradoxe : plus un modèle est gros, moins il devrait être capable de généraliser, et ce n’est pourtant pas ce qu’on constate.
D’abord, pourquoi un modèle gros devrait-il être moins bon ? C’est peut être ça qui vous paraitra paradoxal. Eh bien, si un modèle possède beaucoup de paramètres, il peut “apprendre par cœur” ses données d’entraînement sans trouver de liens entre elles. C’est un peu comme si un élève avait un cerveau assez gros pour tout mémoriser, sans faire de liens entre ses connaissances. Un tel modèle serait excellent lors de l’entraînement mais incapable de généraliser quand on lui donne de nouvelles données. C’est ce qu’on appelle l’overfitting.
Andrej Karpathy (1) a publié il y a quelques mois une longue vidéo (3 heures 30 !) sur le fonctionnement des modèles de langage tels que chatGPT (LLM : large language model). Au cours de cette vidéo, il utilise une analogie, que je trouve parlante, sur les différents types d’apprentissage de ces modèles : apprendre pour une IA, ce serait un peu comme apprendre pour un élève :
1) Lire le cours
C’est la première phase : le pré-entraînement. L’IA “lit” des tonnes de textes (livres, sites universitaires, encyclopédies, etc.). Elle apprend à reconnaître des structures, des phrases, des concepts. Comme un élève qui lit son manuel pour se familiariser avec les bases. A cette étape, elle ne fait qu’ “ingurgiter” l’information lue.
Bien sûr, analogie oblige, ce vocabulaire est très anthropomorphique et il serait plus correct de dire qu’à cette étape, on cherche un programme capable de prédire le mot suivant lorsqu’on lui donne un début de texte, ce qui nécessite d’encoder des régularités statistiques dans les structures, les phrases, les concepts. J’ai fait une animation pour bien comprendre ce qui se passe dans cette phase de “pre-training”, vous la trouverez ici : https://espritcritique.fbfb.eu/fonctionnementLLM/
A l’issue de cette étape, un modèle de langage est presque inutilisable. Il a ingurgité les données mais ne saurait pas les “communiquer”. Par exemple, il risque de prédire que le texte qui vient à la suite d’une question est une autre question car, dans ses données d’entrainement, les questions viennent souvent par listes. Il faut donc passer à la deuxième étape.
Elena Pasquinelli a donné la conférence inaugurale du colloque PraTIC : “Esprit critique et numérique, quand Turing rencontre Piaget” le mercredi 2 avril 2025. La philosophe et chercheuse en sciences cognitives a analysé les atouts et limites de notre esprit critique naturel, ainsi que les stratégies éducatives pour mieux l’armer face aux défis contemporains. Nous avons profité de sa présence exceptionnelle à Genève pour converser avec elle avant la conférence. Nous avons enregistré cet “entretien du SEM” un peu particulier car sans public ! Elena Pasquinelli nous propose son éclairage sur l’enseignement de l’esprit critique et sur les liens avec le numérique dans une vision, vous l’entendrez, résolument optimiste !
Les IA génératives sont impressionnantes, mais on sent que leur utilité varie selon les contextes. Une première idée serait de ne les utiliser que dans les domaines dans lesquels on est expert. Mais il me semble que, plus précisément, les IA génératives sont utiles dans les situations où vérifier est plus simple que produire.
Écrire un texte peut prendre des heures, mais repérer une incohérence ou une faute de style se fait souvent en quelques secondes. De même, générer un code informatique complexe est une tâche ardue, mais tester s’il fonctionne est souvent immédiat; Dans les situations où il y a une telle asymétrie, les IA peuvent proposer une solution rapide, et l’on tranche en un instant si c’est correct et pertinent ou non.
Cela signifierait que les IA ne sont pas utiles à tous pour les même taches. A titre personnel, je les utilise énormément pour coder (il faudra d’ailleurs que je vous en parle: la possibilité de créer en quelques heures des activités numériques pour les élèves me semble un changement potentiellement profond dans l’enseignement !). Pour cet article, créer une image d’illustration aurait pu être un véritable casse-tête, mais vérifier que l’image générée par chatGPT convient – d’après le prompt: “Génère une image qui montre un robot qui donne une copie à un humain qui semble sur le point de la vérifier” – est d’une simplicité enfantine (j’en profite pour créditer l’image!). Les IA génératives sont également très efficaces pour la génération d’idées, toujours suivant la même règle: c’est généralement facile d’évaluer la pertinence et l’intérêt des idées présentées, mais difficile de les avoir.
Peut être que le principe “utilisez des IA génératives dans les cas où vérifier est plus simple que produire” pourrait aider nos élèves à faire un meilleur usage des IA ? Ce n’est qu’une hypothèse, à discuter et tester !
Post-scriptum : Nos lecteurs informaticiens trouveront probablement que cela rappelle le problème ouvert “P = NP ?”, et si vous trouvez cela intrigant, je vous recommande cette vidéo de sciences étonnantes:
On savait que l’arrivée de chatGPT venait avec un risque de voir pulluler de fausses informations, bien rédigées et plus difficiles à “débunker”. Articles, podcasts, vidéos, on a l’impression qu’aucun média n’est épargné ! Voici quelques exemples :
Amazon a dû limiter la publication à 3 livres par jour et par auteur ! La plateforme demande par ailleurs que les livres générés par IA soient signalés comme tel tels. Cette vidéo courte, adressée à public de au public du CO, en parle de manière assez humoristique : https://www.youtube.com/watch?v=DzMKCvdq7_o
Sur youtube de “fausses” vidéos – le texte, la voix et les illustrations sont tous probablement générés par des IAs- apparaissent également. Notamment sur le thème du stoïcisme (dans une acceptation du mot inusuelle). Voir l’intéressante vidéo de Monsieur Phi à ce sujet : https://www.youtube.com/watch?v=rJE2qkP0Gk4
Face à la difficulté d’évaluer la qualité d’une information, il apparaît de plus en plus urgent de former nos élèves à l’esprit critique. Il est essentiel que tous prennent conscience des biais inhérents à la cognition humaine et soient informés des moyens permettant de dépasser ces travers. Ce n’est qu’en prenant connaissance de la manière dont se construit une connaissance de manière fiable et robuste que les jeunes pourront porter un regard sceptique sur les informations auxquelles ils sont exposés.
Les études qui mesurent le développement de l’esprit critique chez les étudiants sont claires : en parler dans son cours ne suffit pas. Des progrès n’ont lieu que si l’on propose des cours spécifiquement dédiés à l’esprit critique, comprenant des contenus théoriques mais aussi des exercices visant à transférer les apprentissages académiques à des situations réelles (source: https://www.oecd-ilibrary.org/education/does-higher-education-teach-students-to-think-critically_cc9fa6aa-en ).
OpenAI fait (à nouveau !) l’actualité cette semaine avec son service chatGPT Search et un mode vocal disponible sur les ordinateurs. On en oublierait qu’il existe d’autres modèles de langage et qu’ils peuvent être tout à fait intéressants, selon vos besoins.
Voici un tableau de quelques services qui me semblent particulièrement intéressants. Si vous utilisez régulièrement chatGPT, je vous encourage à essayer ces alternatives. Elles peuvent toutes être essayées gratuitement, avec un nombre de requêtes maximal différent selon les plateformes.
Intégration poussée dans l’environnement Microsoft et génération de code
Par ailleurs, les modèles de langages utilisés par chatGPT sont parmi les plus “gros” et donc les plus gourmands en énergie. Pour des conversations simples, vous pourriez préférer des modèles plus sobres.
Pour vous faire une idée, n’hésitez pas à tester le site: https://www.comparia.beta.gouv.fr/, proposé par le gouvernement français: il permet de proposer une requête et de comparer les réponses de deux LLMs. Sans qu’on sache de qui vient chaque réponse, on vote pour la meilleure. Puis on nous dévoile qui était derrière chaque réponse et les caractéristiques (nombre de paramètres, type de licence) ainsi que la “dépense” en termes énergétiques.
Une mise en garde avant de clore ce court article : toutes ces IA produisent un contenu dont la fiabilité n’est pas garantie. Vérifiez toujours (souvent plus facile à dire qu’à faire !)
Ce site utilise des cookies de mesure d'audience (Matomo) afin d'établir des statistiques de visite et d'améliorer son contenu. Les données collectées (pages consultées, type d'appareil, navigateur, localisation approximative) ne comprennent pas votre adresse IP, sont hébergées par l'État de Genève et ne sont transmises à aucun tiers.